引入
JAVA提供了一些分析DUMP的工具,比如jmap,visualvm 等
JAVA还有寻找线程状态的工具,jstack等
数据库也有检查连接数,连接状态的命令,status,processlist等
代码中也可以添加一些时间的信息,对比信息发现可优化的地方
但这些都不是今天要记录的内容,今天要做的是使用一个比较暴力的方式查找出高并发模式下运行缓慢的线程
正文
写高并发的时候经常会遇到的问题:
单独观察每个分支线程或者主线程时,都执行地非常快,但是总体上运行的TPS却并不高,没有达到期望的值
更换环境,或者调大运行内存和CPU后,情况仍然不见好转
这时候有个办法是,找出每个线程的运行过程,寻找出耗时较大的代码段,再对代码进行分析
脚本我已经写好了:


1#!/bin/bash
2 parseLog(){
3    ##初始值
4    upLine="blank"
5    last_time_pre="blank"
6    last_time_post="blank"
7    cat "$1" | while read line
8        do
9          time_pre=`echo "$line" | awk '{print$1}'`
10          time_post=`echo "$line" | awk '{print$2}'`
11          if [[ `echo "$time_post" | grep ":"` != "" ]]
12            then
13            if [[ "$upLine" == "blank" ]]
14            then
15              upLine=${line}
16              last_time_pre=`echo "$line" | awk '{print$1}'`
17              last_time_post=`echo "$line" | awk '{print$2}'`
18              total2="$last_time_pre"" $last_time_post"
19              last_time_pre=`date +%s -d "$total2"`
20              last_time_pre=`expr "$last_time_pre" \* 1000`
21              last_time_post=`echo ${last_time_post:9:3}`
22            else
23              total="$time_pre"" $time_post"
24              time_pre=`date +%s -d "$total"`
25              time_pre=`expr "$time_pre" \* 1000`
26              time_post=`echo ${time_post:9:3}`
27              time_end=`expr "$time_pre" + "$time_post"`
28              time_begin=`expr "$last_time_pre" + "$last_time_post" + "$2"`
29              last_time_pre=${time_pre}
30              last_time_post=${time_post}
31              if [[ "$time_end" -gt "$time_begin" ]]
32                then
33                    echo ${upLine} >> result.log
34                    echo ${line} >> result.log
35              fi
36              upLine=${line}
37            fi
38          fi
39        done
40}
41
42
43if [[ ! -n "$1" ]] || [[ ! -n "$2" ]] || [[ ! -n "$3" ]]
44  then
45    echo [log file] [interval millis] [key words]
46    exit
47fi
48
49
50awk '{num[$4]++}
51      END{for(k in num)print k,"----",num[k]|"sort -k 3  -rn"}' "$1" |
52      head -n 15 | awk '{str[$1]++} END{for (s in str)print s}'| grep "$3" > thread.log
53
54
55##对上述输出的每一个线程做分析处理,调用parseLog
56cat thread.log | while read line
57    do
58      grep "\""${line}"\""  "$1" > temp.log
59      parseLog temp.log $2
60    done
61exit
View Code
这个脚本有个基础条件是,分析的日志必须得是按照一定规范输出的日志,输出字段中带有时间和线程名
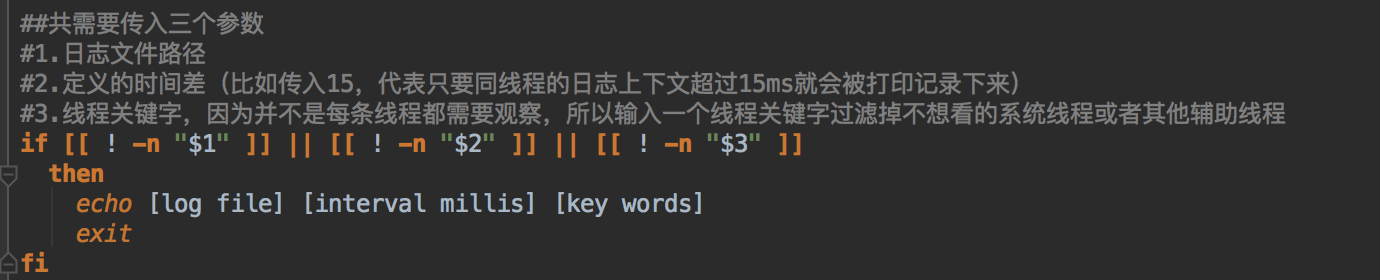
脚本传参:
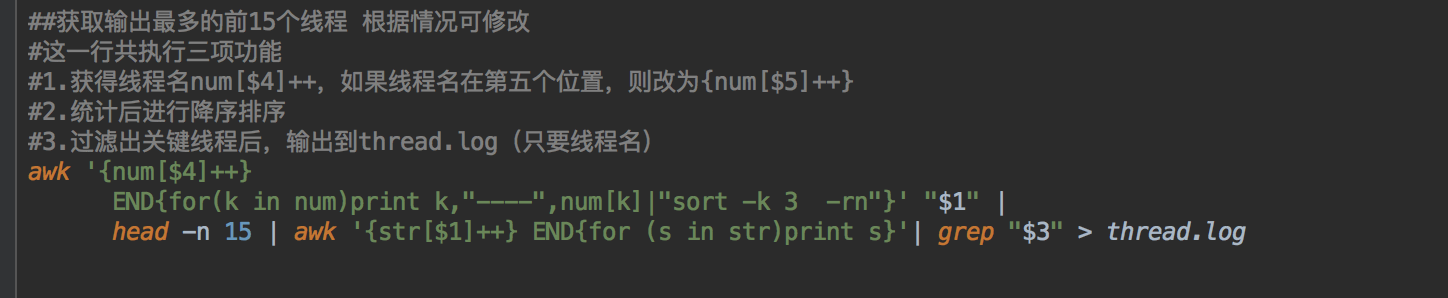
获得可以分析的所有线程,按照数量排序,并只获得前15个
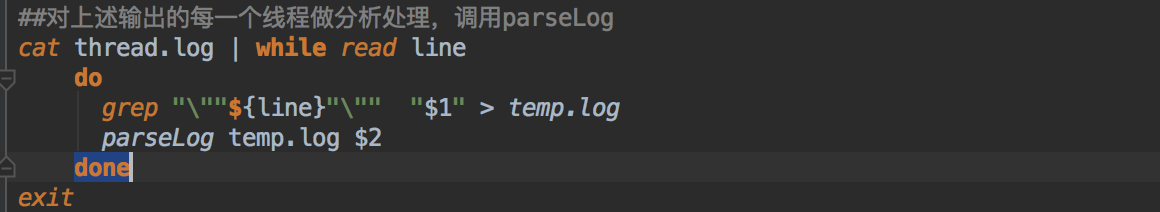
接下来对每一个过滤出来的线程做分析处理
最后就是分析日志的方法了
主要思路是,用下一行的时间减去上一行的时间,如果超过给定的值,就将两行都输出到指定文件。
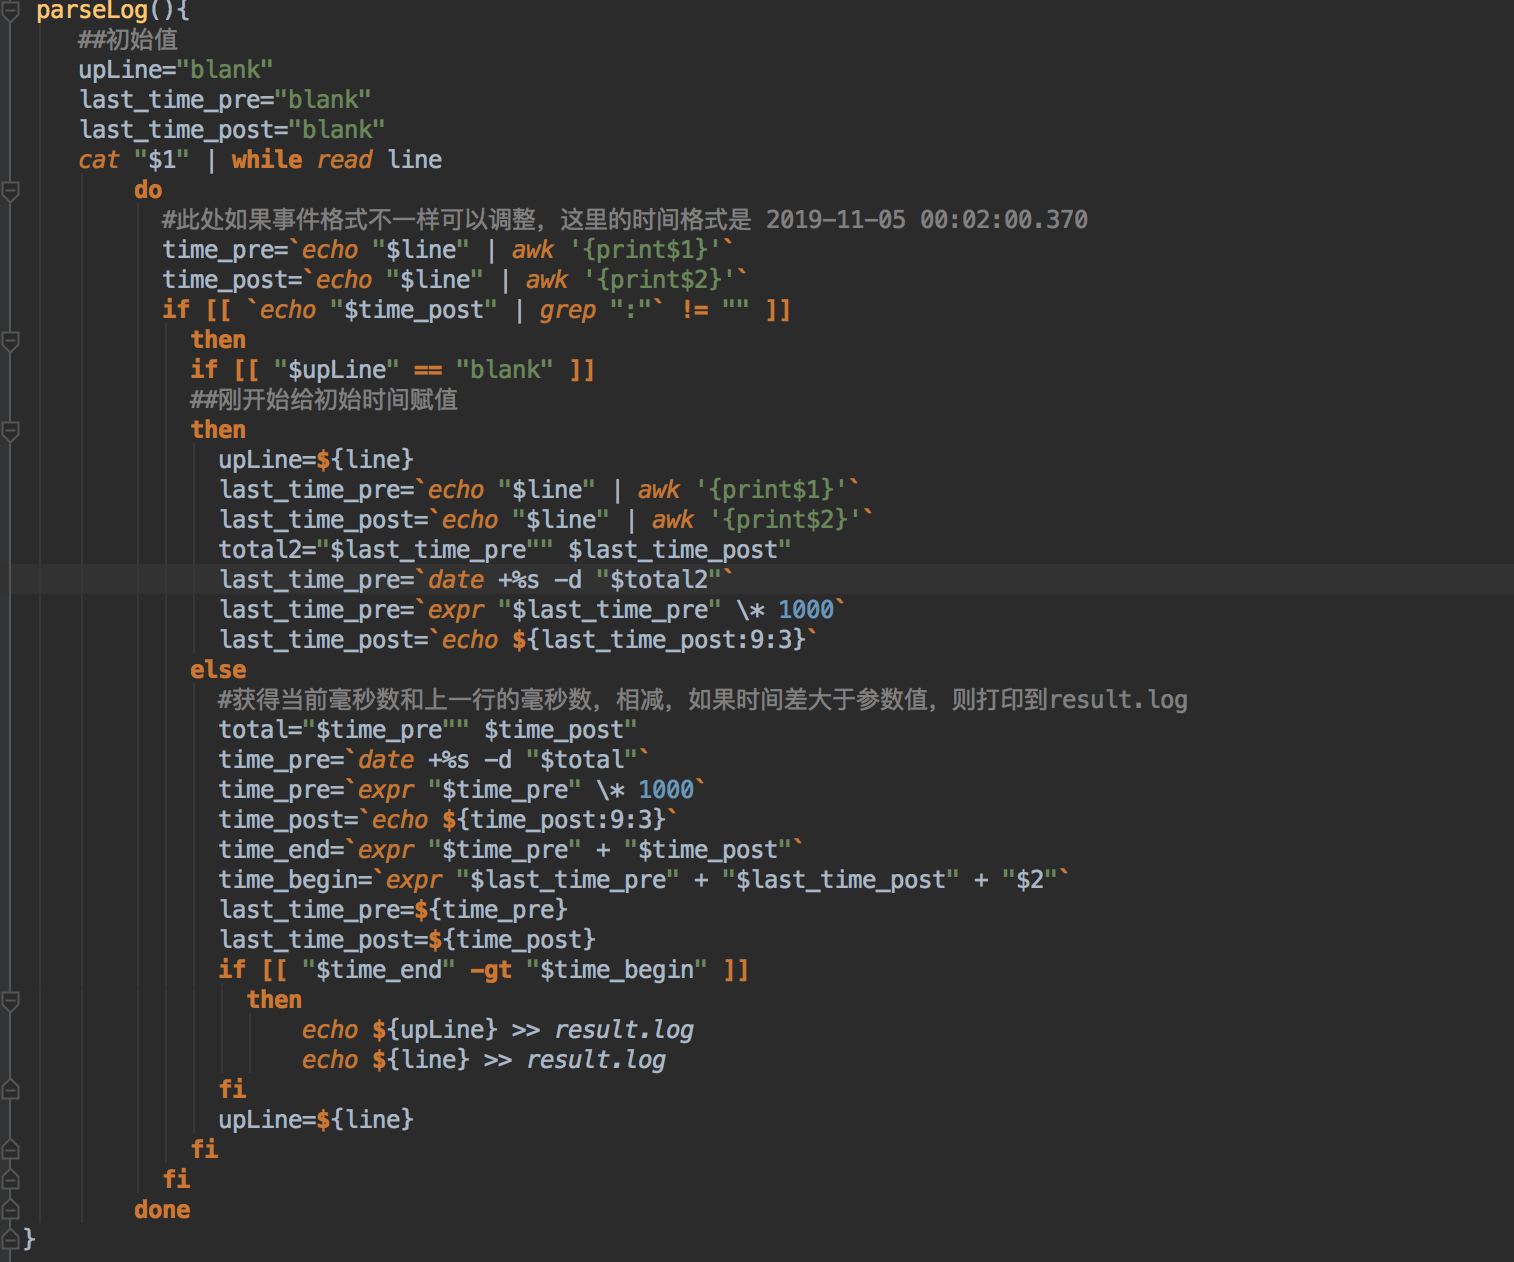
执行效果:
1[utap@host145 logs]$ sh pick_thread.sh bb.log 1 timer
2timerQ_3-service-#146]
3[utap@host145 logs]$ cat result.log
42019-11-05 00:02:00.371 [DEBUG] [TaskRule:405][printExpr] [timerQ_3-service-#146] [100000000004] - TaskRule printExpr i-j=2-0, expr[i].elementAt(j).m_min=0, m_max=9999
52019-11-05 00:02:00.373 [DEBUG] [TaskRule:405][printExpr] [timerQ_3-service-#146] [100000000004] - TaskRule printExpr i-j=3-0, expr[i].elementAt(j).m_min=0, m_max=9999^C
方便再次使用到吧,地址在 https://github.com/garfieldcgf/notes/tree/master/operations/bin