背景描述
1# Time: 2019-01-24T00:08:14.705724+08:00
2# User@Host: **[**] @  [**]  Id: **
3# Schema: sentrymeta  Last_errno: 0  Killed: 0
4# Query_time: 0.315758  Lock_time: 0.001693  Rows_sent: 9664  Rows_examined: 36413  Rows_affected: 0
5# Bytes_sent: 1616970  Tmp_tables: 1  Tmp_disk_tables: 1  Tmp_table_sizes: 16384
6# QC_Hit: No  Full_scan: No  Full_join: No  Tmp_table: Yes  Tmp_table_on_disk: Yes
7# Filesort: No  Filesort_on_disk: No  Merge_passes: 0
8#   InnoDB_IO_r_ops: 0  InnoDB_IO_r_bytes: 0  InnoDB_IO_r_wait: 0.000000
9#   InnoDB_rec_lock_wait: 0.000000  InnoDB_queue_wait: 0.000000
10#   InnoDB_pages_distinct: 1085
11
12total       used       free     shared    buffers     cached
13Mem:           125         38         87          0          0         19
14-/+ buffers/cache:         18        107
15Swap:           31          0         31
16
17root@(none)04:33:02>select version();
18+---------------+
19| version()     |
20+---------------+
21| 5.7.19-17-log |
22+---------------+
231 row in set (0.00 sec)
24
25root@(none)04:33:07>show variables like '%table_size%';
26+---------------------+-----------+
27| Variable_name       | Value     |
28+---------------------+-----------+
29| max_heap_table_size | 134217728 |
30| tmp_table_size      | 16777216  |
31+---------------------+-----------+
322 rows in set (0.00 sec)
问题分析
Q1:为什么会产生临时表?
这个不多说,SQL写的惹不起,反正就是半个小时看不懂的那种,就是一眼就知道一定会产生临时表的😂~~~
Q2:登录到机器上去查看内存使用偏小?
因为这个物理机的内存是125G,但是mysql的总数据量不超过1G,所有实际并不需要多少内存就可以将所有数据都加载都内存中。
Q3:既然内存够用,为啥还要在磁盘上产生临时表?
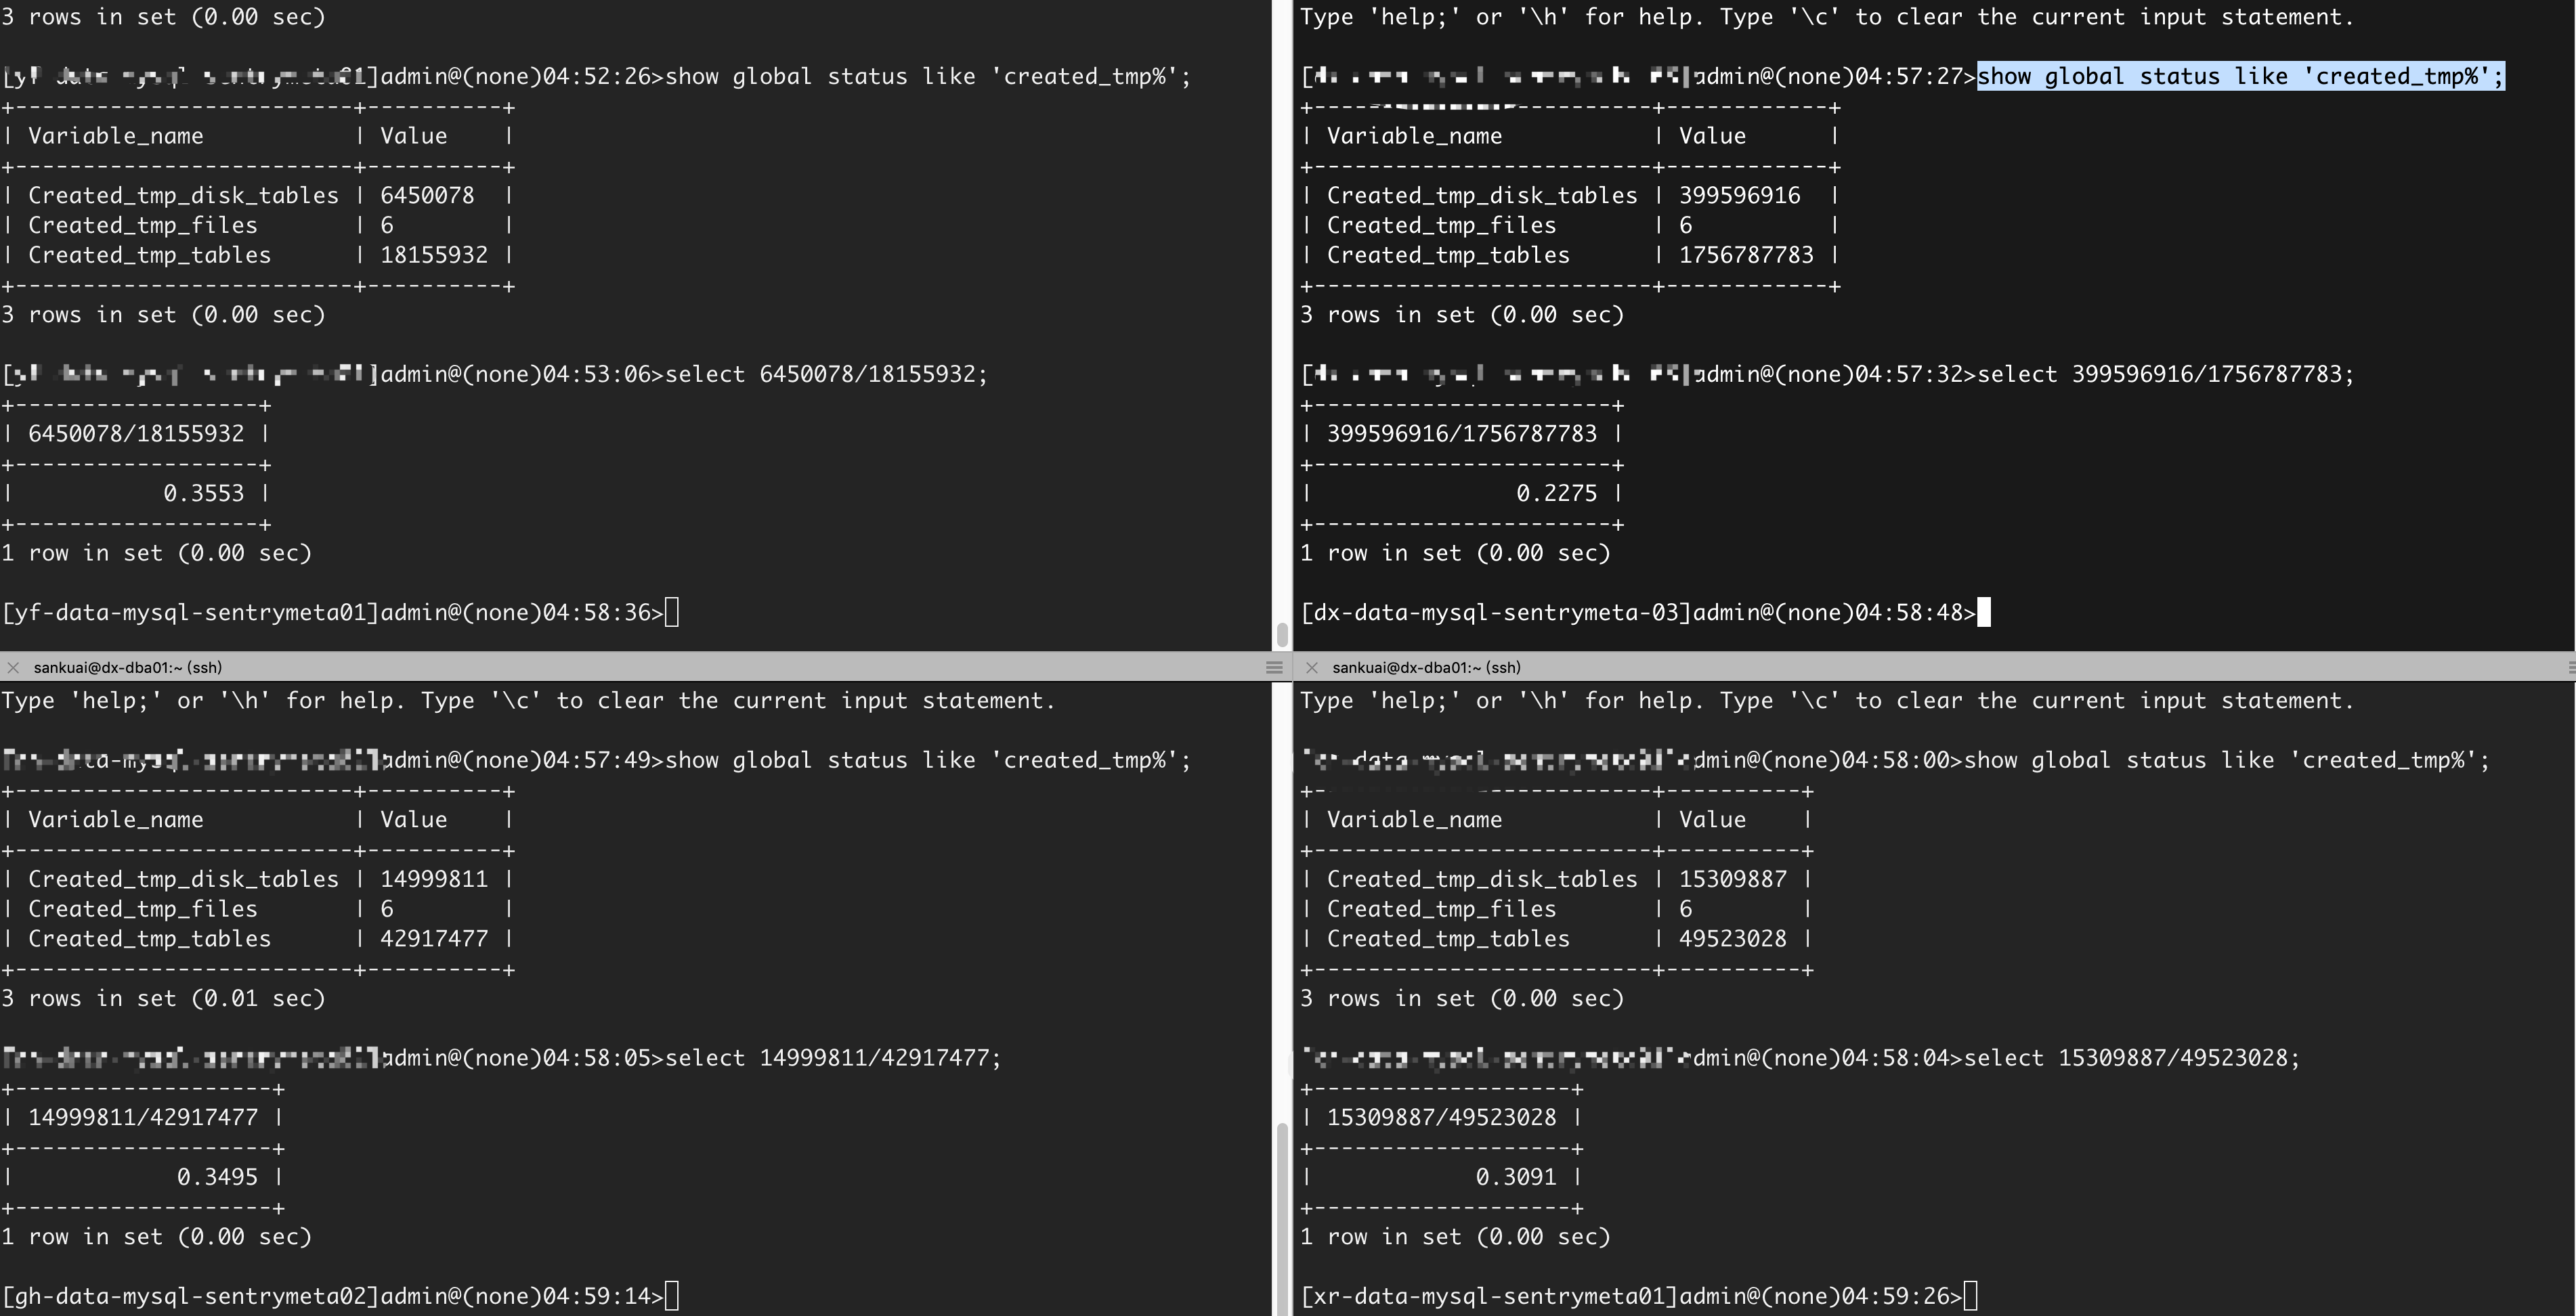
后面可以看见数据库配置的临时表空间是16M,从慢查询日志上来看每一个临时表的大小是16K,在QPS达到一定量了之后,临时表空间就达到了上限,就会产生临时磁盘表,看图下面的产生的【临时磁盘表/临时表】的比例也是符合预期,现在大概就每3条SQL其中有一条会产生临时表。解决办法就是把tmp_table_size这个参数调大,按照当前的计算,调大一半8M可以解决问题。但是,我现在的机器配置很豪,就开心的调大10倍啦~~~~
Q4:磁盘上产生临时表真的是SQL慢的根本原因吗?
通常我们会认为产生了临时表,就更不用说临时磁盘表,大部分就能确定慢查询的原因了。但是这次我还是怀疑了一下,实在是机器性能太好,想着16K的临时表真的有这么大的影响吗,而且我的磁盘性能【SSD、PCIE】感觉也很棒,O(∩_∩)O哈哈~。所以我统计了一下各个阶段的执行时间,发现 converting HEAP to ondisk 从内存中拷贝数据到磁盘消耗的时间并不多,16K对于这种高配的机器还是小case,真正的时间消耗在sending data上,为啥会这样呢?看上面的慢查询日志发现 Bytes_sent: 1616970 这个是1.54M,消耗时间比较多的是从引擎层发送数据给server层,因为这个SQL最后访问的数据比较多。做个简单测试,右边是原来的SQL执行时间,左边是我limit 5的统计结果,可以很直观的看到sending data时间上的差异,时间上查了0.011001/0.000131 ~ 84倍。但是这个和数据行数并不是线性增长关系的,原因嘛就是磁盘的访问方式。
1show profile for query 8;
2+----------------------+----------+
3| Status               | Duration |
4+----------------------+----------+
5| starting             | 0.000082 |
6| checking permissions | 0.000003 |
7| checking permissions | 0.000001 |
8| checking permissions | 0.000003 |
9| Opening tables       | 0.000015 |
10| init                 | 0.000024 |
11| System lock          | 0.000010 |
12| optimizing           | 0.000010 |
13| statistics           | 0.000098 |
14| preparing            | 0.000014 |
15| Creating tmp table   | 0.000033 |
16| executing            | 0.000002 |
17| Sending data         | 0.000131 |
18| end                  | 0.000003 |
19| query end            | 0.000005 |
20| removing tmp table   | 0.000049 |
21| query end            | 0.000002 |
22| closing tables       | 0.000015 |
23| freeing items        | 0.000030 |
24| cleaning up          | 0.000017 |
25+----------------------+----------+
2620 rows in set, 1 warning (0.00 sec)
27
28show profile for query 1;
29+---------------------------+----------+
30| Status                    | Duration |
31+---------------------------+----------+
32| starting                  | 0.000165 |
33| checking permissions      | 0.000005 |
34| checking permissions      | 0.000002 |
35| checking permissions      | 0.000006 |
36| Opening tables            | 0.000027 |
37| init                      | 0.000057 |
38| System lock               | 0.000015 |
39| optimizing                | 0.000025 |
40| statistics                | 0.000235 |
41| preparing                 | 0.000031 |
42| Creating tmp table        | 0.000066 |
43| executing                 | 0.000003 |
44| Sending data              | 0.011001 |
45| converting HEAP to ondisk | 0.005307 |
46| Sending data              | 0.059461 |
47| end                       | 0.000004 |
48| query end                 | 0.000011 |
49| removing tmp table        | 0.000137 |
50| query end                 | 0.000004 |
51| closing tables            | 0.000026 |
52| freeing items             | 0.000026 |
53| cleaning up               | 0.000022 |
54+---------------------------+----------+
5522 rows in set, 1 warning (0.00 sec)