
⭐️基础链接导航⭐️
服务器 → ☁️ 阿里云活动地址
看样例 → 🐟 摸鱼小网站地址
学代码 → 💻 源码库地址
一、前言
大家好呀,我是summo,第一篇已经教会大家怎么去阿里云买服务器,以及怎么搭建JDK、Redis、MySQL这些环境。第二篇我们把后端的应用搭建好了,并且完成了第一个爬虫(抖音)。那么这一篇我会教大家如何将爬取到的数据保存到数据库,并且可以通过接口获取到,为后面的前端界面提供数据源。
二、表结构设计
热搜表结构一览如下

建表语句如下
1CREATE TABLE `t_sbmy_hot_search` (
2  `id` bigint(20) unsigned zerofill NOT NULL AUTO_INCREMENT COMMENT '物理主键',
3  `hot_search_id` varchar(255) CHARACTER SET utf8mb4 COLLATE utf8mb4_0900_ai_ci DEFAULT NULL COMMENT '热搜ID',
4  `hot_search_excerpt` text CHARACTER SET utf8mb4 COLLATE utf8mb4_0900_ai_ci COMMENT '热搜摘录',
5  `hot_search_heat` varchar(255) CHARACTER SET utf8mb4 COLLATE utf8mb4_0900_ai_ci DEFAULT NULL COMMENT '热搜热度',
6  `hot_search_title` varchar(2048) CHARACTER SET utf8mb4 COLLATE utf8mb4_0900_ai_ci DEFAULT NULL COMMENT '热搜标题',
7  `hot_search_url` text CHARACTER SET utf8mb4 COLLATE utf8mb4_0900_ai_ci COMMENT '热搜链接',
8  `hot_search_cover` text CHARACTER SET utf8mb4 COLLATE utf8mb4_0900_ai_ci COMMENT '热搜封面',
9  `hot_search_author` varchar(255) CHARACTER SET utf8mb4 COLLATE utf8mb4_0900_ai_ci DEFAULT NULL COMMENT '热搜作者',
10  `hot_search_author_avatar` text CHARACTER SET utf8mb4 COLLATE utf8mb4_0900_ai_ci COMMENT '热搜作者头像',
11  `hot_search_resource` varchar(255) CHARACTER SET utf8mb4 COLLATE utf8mb4_0900_ai_ci DEFAULT NULL COMMENT '热搜来源',
12  `hot_search_order` int DEFAULT NULL COMMENT '热搜排名',
13  `gmt_create` datetime DEFAULT NULL COMMENT '创建时间',
14  `gmt_modified` datetime DEFAULT NULL COMMENT '更新时间',
15  `creator_id` bigint DEFAULT NULL COMMENT '创建人',
16  `modifier_id` bigint DEFAULT NULL COMMENT '更新人',
17   PRIMARY KEY (`id`) USING BTREE
18) ENGINE=InnoDB AUTO_INCREMENT=1 DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci;
19
其中核心字段是
hot_search_id、hot_search_title、hot_search_url、hot_search_heat这四个字段,这几个字段是一定会有值的,其他的字段看热搜接口给不给值,有就填没有就空,把这个建表语句执行一下就可以创建出热搜记录表了。
三、使用插件生成Java对象
Java映射表结构对象的生成有很多方式,这里我推荐使用mybatis插件的方式生成,操作非常简单,一次配好后面的对象都可以这样生成(ps:我用的开发工具是idea社区版)。
1. 在summo-sbmy-dao这个module的resources目录下创建generator目录

2. 在generator目录创建config.properties文件
内容如下
1# JDBC链接
2jdbc.url=jdbc:mysql://xxx:3306/summo-sbmy?characterEncoding=utf8&useSSL=false&serverTimezone=Asia/Shanghai&rewriteBatchedStatements=true
3# 用户名
4jdbc.user=root
5# 密码
6jdbc.password=xxx
7# 表名
8table.name=t_sbmy_hot_search
9# 对象名
10entity.name=SbmyHotSearchDO
11# Mapper
12mapper.name=SbmyHotSearchMapper
这是一个配置文件,将需要创建Java的对象的表写到这来再设置好对象名即可。
3. 在generator目录创建generatorConfiguration.xml文件
内容如下
1<!DOCTYPE generatorConfiguration
2        PUBLIC "-//mybatis.org//DTD MyBatis Generator Configuration 1.0//EN"
3        "http://mybatis.org/dtd/mybatis-generator-config_1_0.dtd">
4
5<generatorConfiguration>
6    <properties resource="generator/config.properties"/>
7
8    <!-- MySQL数据库驱动jar包路径,全路径 -->
9    <classPathEntry location="/xxx/mysql-connector-java-8.0.11.jar"/>
10    <context id="Mysql" targetRuntime="MyBatis3Simple" defaultModelType="flat">
11        <property name="beginningDelimiter" value="`"/>
12        <property name="endingDelimiter" value="`"/>
13
14        <plugin type="tk.mybatis.mapper.generator.MapperPlugin">
15            <property name="mappers" value="com.baomidou.mybatisplus.core.mapper.BaseMapper"/>
16            <!-- 插件默认的通用mapper <property name="mappers" itemValue="tk.mybatis.mapper.common.Mapper"/>-->
17            <property name="caseSensitive" value="true"/>
18            <property name="lombok" value="Getter,Setter,Builder,NoArgsConstructor,AllArgsConstructor"/>
19        </plugin>
20
21        <!-- 数据库连接 -->
22        <jdbcConnection driverClass="com.mysql.cj.jdbc.Driver"
23                        connectionURL="${jdbc.url}"
24                        userId="${jdbc.user}" password="${jdbc.password}"/>
25
26        <!-- entity路径 -->
27        <javaModelGenerator targetPackage="com.summo.sbmy.dao.entity"
28                            targetProject="src/main/java"/>
29
30        <!-- xml路径 -->
31        <sqlMapGenerator targetPackage="mybatis/mapper"
32                         targetProject="src/main/resources/">
33            <property name="enableSubPackages" value="true"/>
34        </sqlMapGenerator>
35
36        <!-- mapper路径 -->
37        <javaClientGenerator targetPackage="com.summo.sbmy.dao.mapper"
38                             targetProject="src/main/java"
39                             type="XMLMAPPER">
40        </javaClientGenerator>
41
42        <!-- 自增ID路径 -->
43        <table tableName="${table.name}" domainObjectName="${entity.name}"
44               mapperName="${mapper.name}">
45            <generatedKey column="id" sqlStatement="Mysql" identity="true"/>
46        </table>
47
48    </context>
49</generatorConfiguration>
这是生成的逻辑规则,设置指定的entity、dao、mapper等文件位置。这两个文件配置好之后,刷新一下maven仓库,插件就会自动识别到了。
4. 双击mybatis-generator:generate生成对象
找到插件执行的位置

双击mybatis-generator:generate就可以生成对应的DO、Mapper、xml了,不过其他的类像controller、service和repository生成不了,需要自己创建。这里最终的目录结构如下
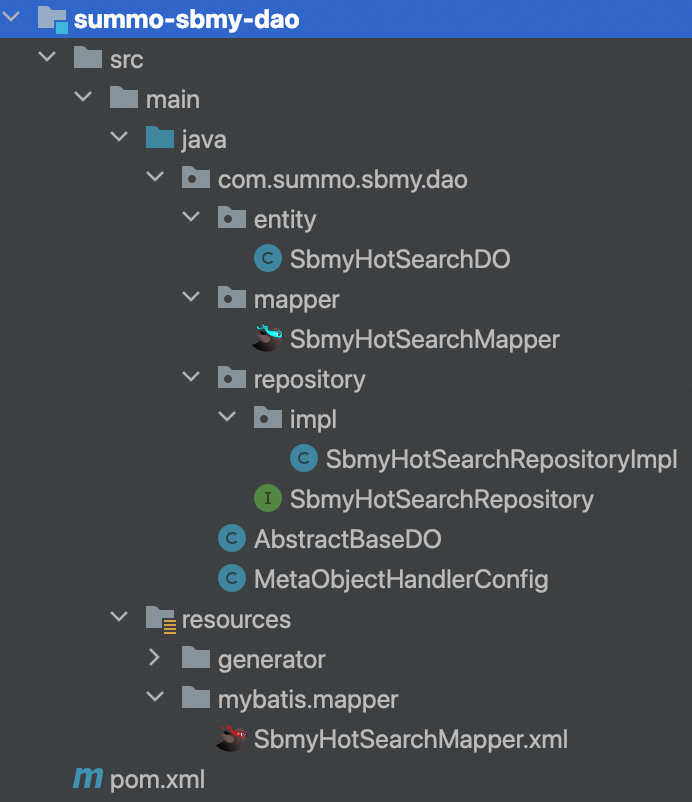
这里的repository代码是我加上去的,插件生成不了,我还加了一个
AbstractBaseDO,它是一个抽象父类,所有的DO都会继承它;还加了一个MetaObjectHandlerConfig,用于对SQL进行切面处理,最后有些代码还有些微调。我把代码贴一下,详情可以见我的代码仓库。
SbmyHotSearchDO.java
1package com.summo.sbmy.dao.entity;
2
3import java.util.Date;
4import javax.persistence.*;
5
6import com.baomidou.mybatisplus.annotation.IdType;
7import com.baomidou.mybatisplus.annotation.TableId;
8import com.baomidou.mybatisplus.annotation.TableName;
9import com.summo.sbmy.dao.AbstractBaseDO;
10import lombok.AllArgsConstructor;
11import lombok.Builder;
12import lombok.Getter;
13import lombok.NoArgsConstructor;
14import lombok.Setter;
15import lombok.ToString;
16
17@Getter
18@Setter
19@TableName("t_sbmy_hot_search")
20@NoArgsConstructor
21@AllArgsConstructor
22@Builder
23@ToString
24public class SbmyHotSearchDO  extends AbstractBaseDO<SbmyHotSearchDO> {
25    /**
26     * 物理主键
27     */
28    @TableId(type = IdType.AUTO)
29    private Long id;
30
31    /**
32     * 热搜标题
33     */
34    @Column(name = "hot_search_title")
35    private String hotSearchTitle;
36
37    /**
38     * 热搜作者
39     */
40    @Column(name = "hot_search_author")
41    private String hotSearchAuthor;
42
43    /**
44     * 热搜来源
45     */
46    @Column(name = "hot_search_resource")
47    private String hotSearchResource;
48
49    /**
50     * 热搜排名
51     */
52    @Column(name = "hot_search_order")
53    private Integer hotSearchOrder;
54
55    /**
56     * 热搜ID
57     */
58    @Column(name = "hot_search_id")
59    private String hotSearchId;
60
61    /**
62     * 热搜热度
63     */
64    @Column(name = "hot_search_heat")
65    private String hotSearchHeat;
66
67    /**
68     * 热搜链接
69     */
70    @Column(name = "hot_search_url")
71    private String hotSearchUrl;
72
73    /**
74     * 热搜封面
75     */
76    @Column(name = "hot_search_cover")
77    private String hotSearchCover;
78
79    /**
80     * 热搜作者头像
81     */
82    @Column(name = "hot_search_author_avatar")
83    private String hotSearchAuthorAvatar;
84
85    /**
86     * 热搜摘录
87     */
88    @Column(name = "hot_search_excerpt")
89    private String hotSearchExcerpt;
90}
SbmyHotSearchMapper.java
1package com.summo.sbmy.dao.mapper;
2
3import com.baomidou.mybatisplus.core.mapper.BaseMapper;
4import com.summo.sbmy.dao.entity.SbmyHotSearchDO;
5import org.apache.ibatis.annotations.Mapper;
6
7@Mapper
8public interface SbmyHotSearchMapper extends BaseMapper<SbmyHotSearchDO> {
9}
SbmyHotSearchRepository.java
1package com.summo.sbmy.dao.repository;
2
3import com.baomidou.mybatisplus.extension.service.IService;
4import com.summo.sbmy.dao.entity.SbmyHotSearchDO;
5
6public interface SbmyHotSearchRepository extends IService<SbmyHotSearchDO> {
7}
8
SbmyHotSearchRepositoryImpl.java
1package com.summo.sbmy.dao.repository.impl;
2
3import com.baomidou.mybatisplus.extension.service.impl.ServiceImpl;
4import com.summo.sbmy.dao.entity.SbmyHotSearchDO;
5import com.summo.sbmy.dao.mapper.SbmyHotSearchMapper;
6import com.summo.sbmy.dao.repository.SbmyHotSearchRepository;
7import org.springframework.stereotype.Repository;
8
9@Repository
10public class SbmyHotSearchRepositoryImpl extends ServiceImpl<SbmyHotSearchMapper, SbmyHotSearchDO>
11    implements SbmyHotSearchRepository {
12
13}
14
AbstractBaseDO.java
1package com.summo.sbmy.dao;
2
3import java.io.Serializable;
4import java.util.Date;
5
6import com.baomidou.mybatisplus.annotation.FieldFill;
7import com.baomidou.mybatisplus.annotation.TableField;
8import com.baomidou.mybatisplus.extension.activerecord.Model;
9import lombok.Getter;
10import lombok.Setter;
11
12@Getter
13@Setter
14public class AbstractBaseDO<T extends Model<T>> extends Model<T> implements Serializable {
15
16    /**
17     * 创建时间
18     */
19    @TableField(fill = FieldFill.INSERT)
20    private Date gmtCreate;
21
22    /**
23     * 修改时间
24     */
25    @TableField(fill = FieldFill.INSERT_UPDATE)
26    private Date gmtModified;
27
28    /**
29     * 创建人ID
30     */
31    @TableField(fill = FieldFill.INSERT)
32    private Long creatorId;
33
34    /**
35     * 修改人ID
36     */
37    @TableField(fill = FieldFill.INSERT_UPDATE)
38    private Long modifierId;
39}
40
MetaObjectHandlerConfig.java
1package com.summo.sbmy.dao;
2
3import java.util.Calendar;
4import java.util.Date;
5
6import com.baomidou.mybatisplus.core.handlers.MetaObjectHandler;
7import org.apache.ibatis.reflection.MetaObject;
8import org.springframework.context.annotation.Configuration;
9
10@Configuration
11public class MetaObjectHandlerConfig implements MetaObjectHandler {
12
13    @Override
14    public void insertFill(MetaObject metaObject) {
15        Date date = Calendar.getInstance().getTime();
16        this.fillStrategy(metaObject, "gmtCreate", date);
17        this.fillStrategy(metaObject, "gmtModified", date);
18    }
19
20    @Override
21    public void updateFill(MetaObject metaObject) {
22        Date date = Calendar.getInstance().getTime();
23        this.setFieldValByName("gmtModified", date, metaObject);
24    }
25}
SbmyHotSearchMapper.xml
1<?xml version="1.0" encoding="UTF-8"?>
2<!DOCTYPE mapper PUBLIC "-//mybatis.org//DTD Mapper 3.0//EN" "http://mybatis.org/dtd/mybatis-3-mapper.dtd">
3<mapper namespace="com.summo.sbmy.dao.mapper.SbmyHotSearchMapper">
4  <resultMap id="BaseResultMap" type="com.summo.sbmy.dao.entity.SbmyHotSearchDO">
5    <!--
6      WARNING - @mbg.generated
7    -->
8    <id column="id" jdbcType="BIGINT" property="id" />
9    <result column="hot_search_title" jdbcType="VARCHAR" property="hotSearchTitle" />
10    <result column="hot_search_author" jdbcType="VARCHAR" property="hotSearchAuthor" />
11    <result column="hot_search_resource" jdbcType="VARCHAR" property="hotSearchResource" />
12    <result column="hot_search_order" jdbcType="INTEGER" property="hotSearchOrder" />
13    <result column="gmt_create" jdbcType="TIMESTAMP" property="gmtCreate" />
14    <result column="gmt_modified" jdbcType="TIMESTAMP" property="gmtModified" />
15    <result column="creator_id" jdbcType="BIGINT" property="creatorId" />
16    <result column="modifier_id" jdbcType="BIGINT" property="modifierId" />
17    <result column="hot_search_id" jdbcType="VARCHAR" property="hotSearchId" />
18    <result column="hot_search_heat" jdbcType="VARCHAR" property="hotSearchHeat" />
19    <result column="hot_search_url" jdbcType="LONGVARCHAR" property="hotSearchUrl" />
20    <result column="hot_search_cover" jdbcType="LONGVARCHAR" property="hotSearchCover" />
21    <result column="hot_search_author_avatar" jdbcType="LONGVARCHAR" property="hotSearchAuthorAvatar" />
22    <result column="hot_search_excerpt" jdbcType="LONGVARCHAR" property="hotSearchExcerpt" />
23  </resultMap>
24</mapper>
四、热搜数据存储
1. 唯一ID生成
上一篇的最后我们把抖音的热搜数据给获取到了,这里表结构也设计好了,到存储逻辑就变得简单很多了。这个有一个点需要注意下,由于抖音的热搜没有自带唯一ID,为了不重复添加,我们需要手动给热搜设置一个ID,生成ID的算法如下:
1/**
2   * 根据文章标题获取一个唯一ID
3   *
4   * @param title 文章标题
5   * @return 唯一ID
6   */
7public static String getHashId(String title) {
8  long seed = title.hashCode();
9  Random rnd = new Random(seed);
10  return new UUID(rnd.nextLong(), rnd.nextLong()).toString();
11}
12
13public static void main(String[] args) {
14  System.out.println(getHashId("当你有一只肥猫就会很显瘦"));
15  System.out.println(getHashId("当你有一只肥猫就会很显瘦"));
16  System.out.println(getHashId("当你有一只肥猫就会很显瘦"));
17  System.out.println(getHashId("当你有一只肥猫就会很显瘦"));
18}
运行这串逻辑,输出一下代码

从输出结果来看,同一个标题获取的hashId都是一样的,可以满足我们的要求。
2. 数据存储流程
保存的逻辑流程如下图,核心就是根据那个唯一ID去数据库查询一下,有就跳过,没有就保存。

DouyinHotSearchJob代码如下
1package com.summo.sbmy.job.douyin;
2
3import java.io.IOException;
4import java.util.List;
5import java.util.Random;
6import java.util.UUID;
7
8import com.alibaba.fastjson.JSONArray;
9import com.alibaba.fastjson.JSONObject;
10
11import com.google.common.collect.Lists;
12import com.summo.sbmy.dao.entity.SbmyHotSearchDO;
13import com.summo.sbmy.service.SbmyHotSearchService;
14import lombok.extern.slf4j.Slf4j;
15import okhttp3.OkHttpClient;
16import okhttp3.Request;
17import okhttp3.Response;
18import org.springframework.beans.factory.annotation.Autowired;
19import org.springframework.scheduling.annotation.Scheduled;
20import org.springframework.stereotype.Component;
21
22import static com.summo.sbmy.common.enums.HotSearchEnum.DOUYIN;
23
24/**
25 * @author summo
26 * @version DouyinHotSearchJob.java, 1.0.0
27 * @description 抖音热搜Java爬虫代码
28 * @date 2024年08月09
29 */
30@Component
31@Slf4j
32public class DouyinHotSearchJob {
33
34    @Autowired
35    private SbmyHotSearchService sbmyHotSearchService;
36
37    /**
38     * 定时触发爬虫方法,1个小时执行一次
39     */
40    @Scheduled(fixedRate = 1000 * 60 * 60)
41    public void hotSearch() throws IOException {
42        try {
43            //查询抖音热搜数据
44            OkHttpClient client = new OkHttpClient().newBuilder().build();
45            Request request = new Request.Builder().url(
46                "https://www.iesdouyin.com/web/api/v2/hotsearch/billboard/word/").method("GET", null).build();
47            Response response = client.newCall(request).execute();
48            JSONObject jsonObject = JSONObject.parseObject(response.body().string());
49            JSONArray array = jsonObject.getJSONArray("word_list");
50            List<SbmyHotSearchDO> sbmyHotSearchDOList = Lists.newArrayList();
51            for (int i = 0, len = array.size(); i < len; i++) {
52                //获取知乎热搜信息
53                JSONObject object = (JSONObject)array.get(i);
54                //构建热搜信息榜
55                SbmyHotSearchDO sbmyHotSearchDO = SbmyHotSearchDO.builder().hotSearchResource(DOUYIN.getCode()).build();
56                //设置文章标题
57                sbmyHotSearchDO.setHotSearchTitle(object.getString("word"));
58                //设置抖音三方ID
59                sbmyHotSearchDO.setHotSearchId(getHashId(DOUYIN.getCode() + sbmyHotSearchDO.getHotSearchTitle()));
60                //设置文章连接
61                sbmyHotSearchDO.setHotSearchUrl(
62                    "https://www.douyin.com/search/" + sbmyHotSearchDO.getHotSearchTitle() + "?type=general");
63                //设置热搜热度
64                sbmyHotSearchDO.setHotSearchHeat(object.getString("hot_value"));
65                //按顺序排名
66                sbmyHotSearchDO.setHotSearchOrder(i + 1);
67                sbmyHotSearchDOList.add(sbmyHotSearchDO);
68            }
69            //数据持久化
70            sbmyHotSearchService.saveCache2DB(sbmyHotSearchDOList);
71        } catch (IOException e) {
72            log.error("获取抖音数据异常", e);
73        }
74    }
75
76    /**
77     * 根据文章标题获取一个唯一ID
78     *
79     * @param title 文章标题
80     * @return 唯一ID
81     */
82    public static String getHashId(String title) {
83        long seed = title.hashCode();
84        Random rnd = new Random(seed);
85        return new UUID(rnd.nextLong(), rnd.nextLong()).toString();
86    }
87
88}
这里的爬虫代码我做了微调,去掉了一些不必要的header和cookie。
数据存储逻辑如下
1@Override
2public Boolean saveCache2DB(List<SbmyHotSearchDO> sbmyHotSearchDOS) {
3  if (CollectionUtils.isEmpty(sbmyHotSearchDOS)) {
4    return Boolean.TRUE;
5  }
6  //查询当前数据是否已经存在
7  List<String> searchIdList = sbmyHotSearchDOS.stream().map(SbmyHotSearchDO::getHotSearchId).collect(
8            Collectors.toList());
9  List<SbmyHotSearchDO> sbmyHotSearchDOList = sbmyHotSearchRepository.list(
10            new QueryWrapper<SbmyHotSearchDO>().lambda().in(SbmyHotSearchDO::getHotSearchId, searchIdList));
11  //过滤已经存在的数据
12  if (CollectionUtils.isNotEmpty(sbmyHotSearchDOList)) {
13    List<String> tempIdList = sbmyHotSearchDOList.stream().map(SbmyHotSearchDO::getHotSearchId).collect(
14                Collectors.toList());
15    sbmyHotSearchDOS = sbmyHotSearchDOS.stream().filter(
16                sbmyHotSearchDO -> !tempIdList.contains(sbmyHotSearchDO.getHotSearchId())).collect(Collectors.toList());
17  }
18  if (CollectionUtils.isEmpty(sbmyHotSearchDOS)) {
19    return Boolean.TRUE;
20  }
21  log.info("本次新增[{}]条数据", sbmyHotSearchDOS.size());
22  //批量添加
23  return sbmyHotSearchRepository.saveBatch(sbmyHotSearchDOS);
24}
这里代码就是我们常说的CRUD了,感觉没有什么可讲的,具体的代码看仓库。
五、小结一下
由于我们这是一个项目,有很多框架级和工程化的东西,细节非常多,如果我把代码全贴出来,那文章估计没法看了,所以后续的文章我只会贴一些核心的代码和逻辑。主要是有些东西没法一时半会跟你们讲清楚,牵扯到脚手架的设计,所以你们先姑妄看之,先一股脑的把代码复制进来,有不理解的地方我可以后面单开文章介绍和解释,讲我为什么要这样做以及这样做有啥好处。
除了代码之外,我还会教大家一些插件的使用,比如上面这个代码生成器,类似于这样的东西我还会很多,我会在后面的文章中慢慢贴出来,让大家学到一些真正好用和好玩的东西。并且从这一篇开始我会放出我的仓库地址,后续的代码会持续更新到这个仓库,由于Github很多人都没法访问,我就用国内的Gitee吧,地址如下:。
番外:百度热搜爬虫
1. 爬虫方案评估
百度热搜是这样的, 接口是:https://top.baidu.com/board?tab=realtime&sa=fyb_realtime_31065
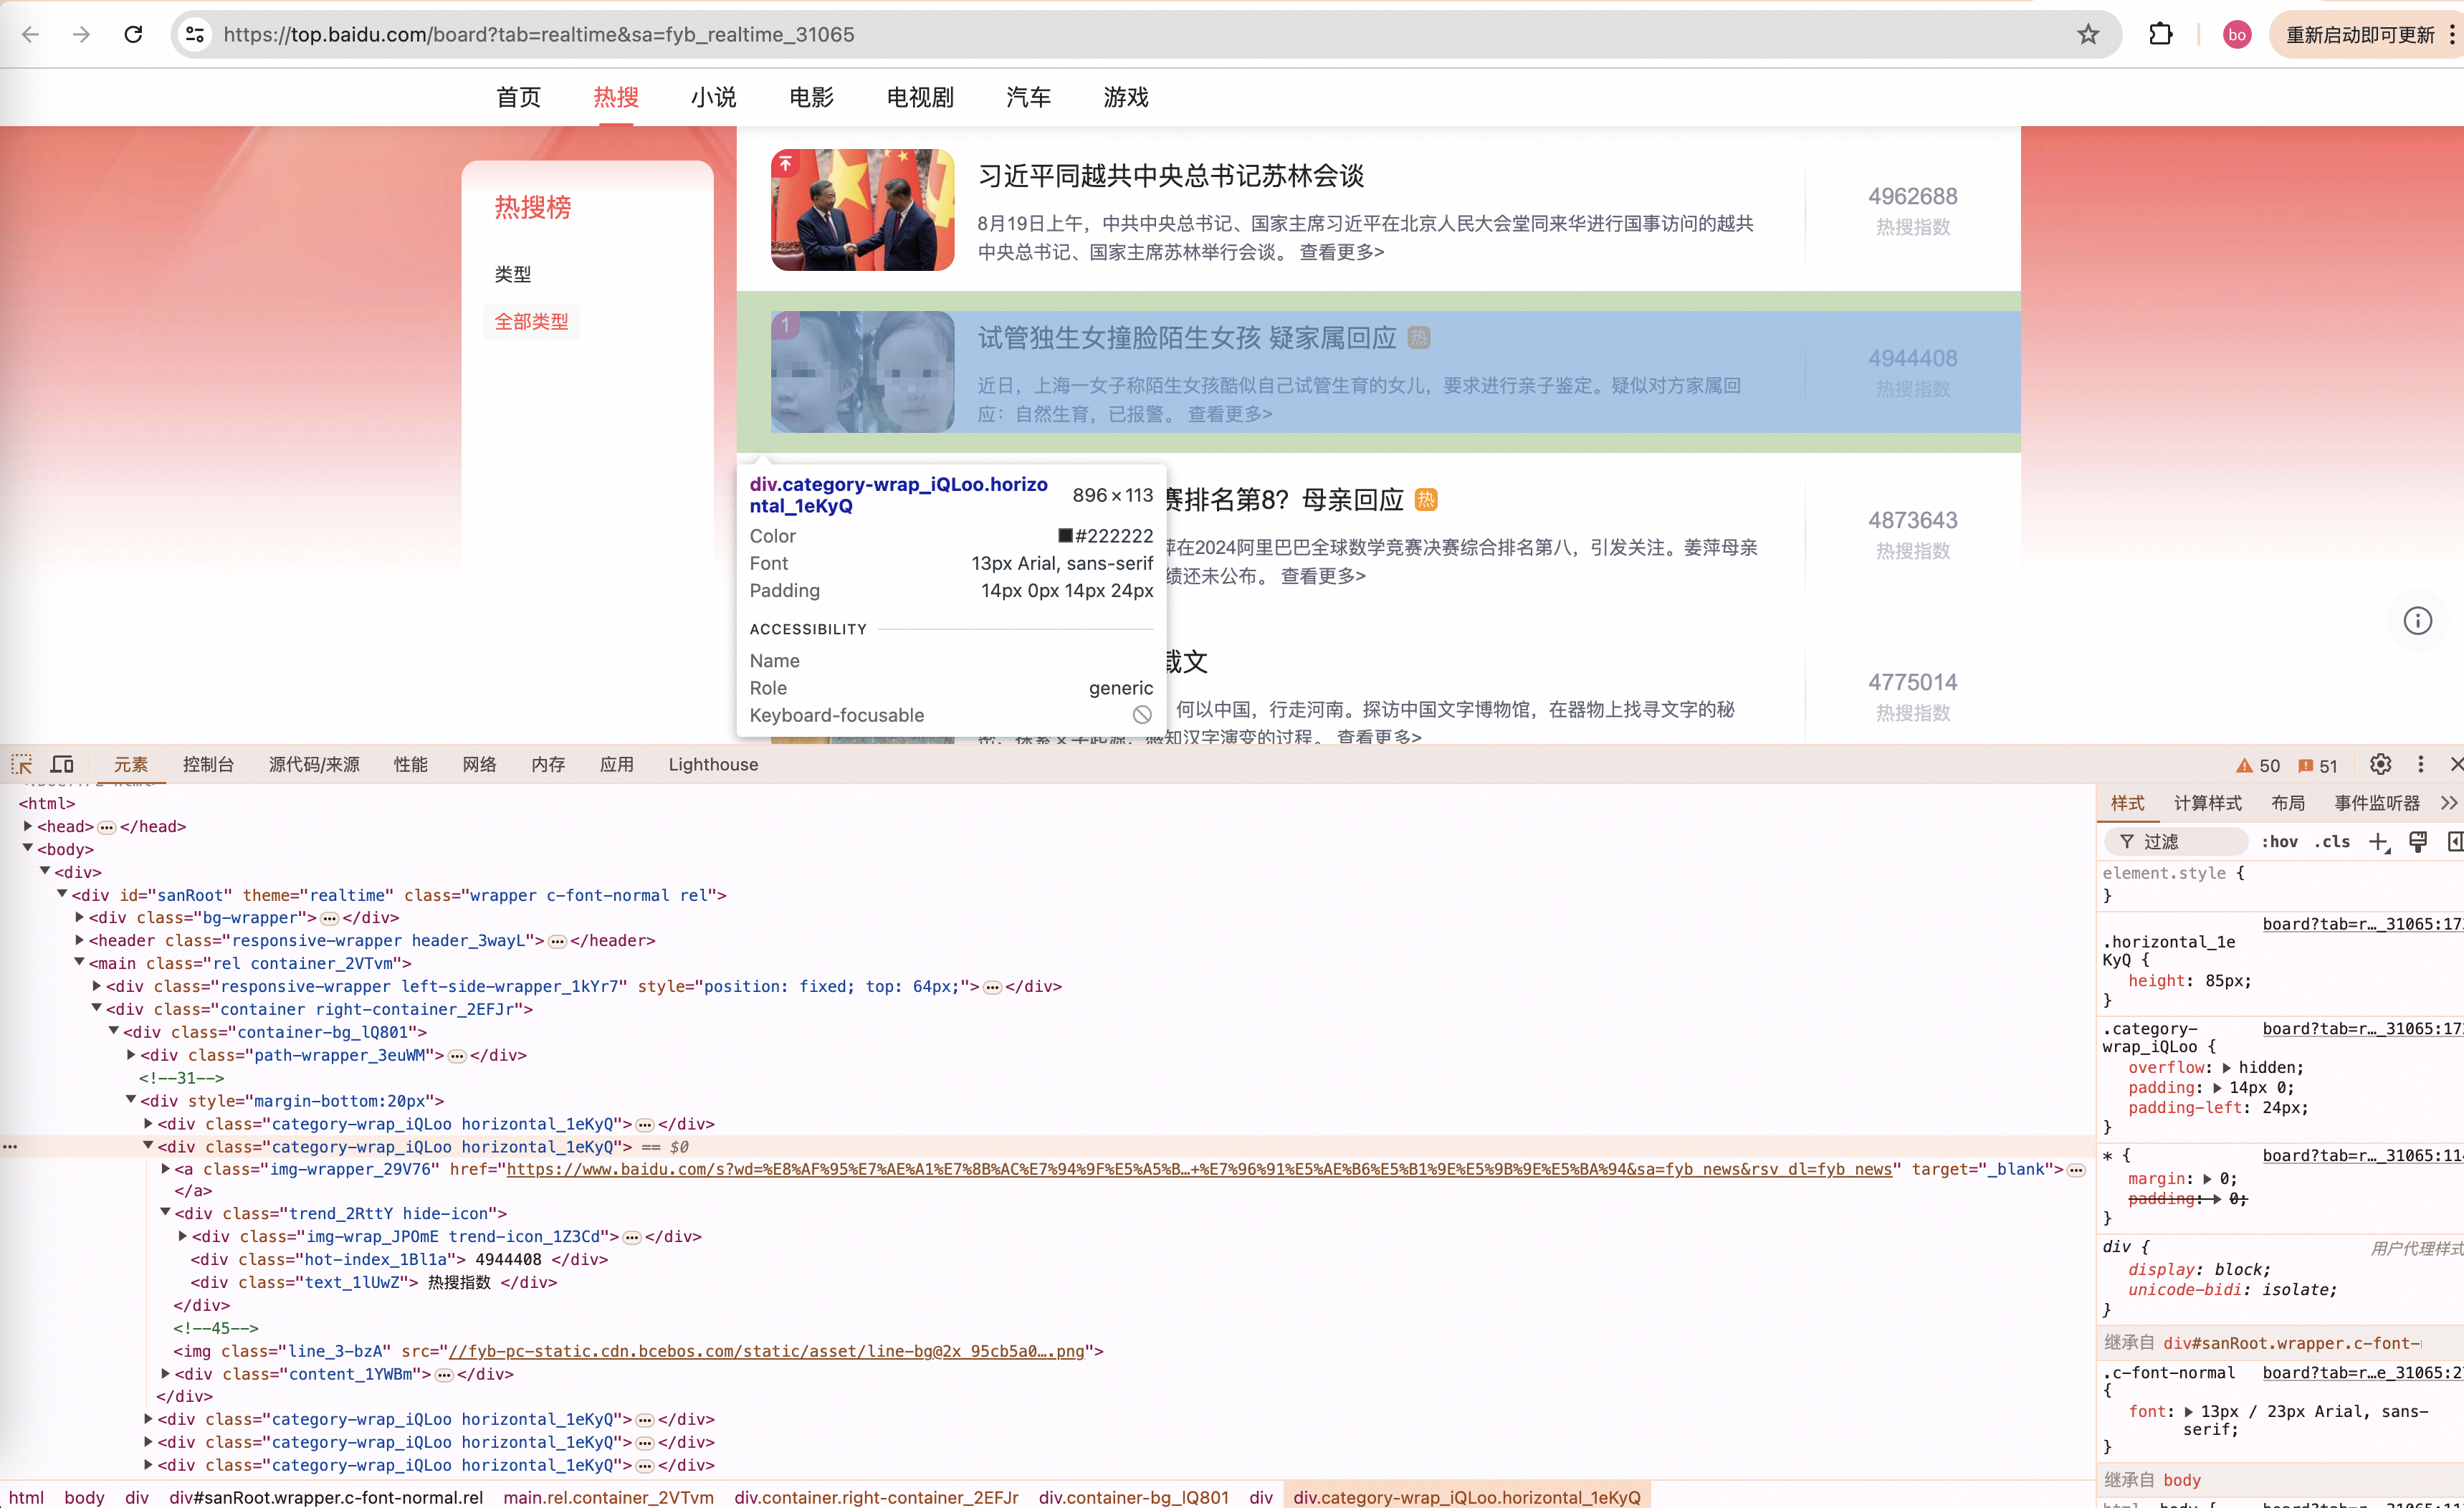
可以看到数据还是很完备的,标题、封面、热度、摘要都有,但是百度热搜和抖音热搜不一样,这个接口返回的HTML网页不是JSON数据,所以我们需要使用处理HTML标签的包:
jsoup,依赖如下:
1<!-- jsoup -->
2<dependency>
3  <groupId>org.jsoup</groupId>
4  <artifactId>jsoup</artifactId>
5  <version>1.12.1</version>
6</dependency>
2. 网页解析代码
这个用Postman就不太好使了,我们直接用jsonp进行调用,不逼逼逻辑了,直接上代码,BaiduHotSearchJob:
1package com.summo.sbmy.job.baidu;
2
3import java.io.IOException;
4import java.util.ArrayList;
5import java.util.List;
6import java.util.Random;
7import java.util.UUID;
8
9import com.summo.sbmy.dao.entity.SbmyHotSearchDO;
10import com.summo.sbmy.service.SbmyHotSearchService;
11import lombok.extern.slf4j.Slf4j;
12import org.jsoup.Jsoup;
13import org.jsoup.nodes.Document;
14import org.jsoup.select.Elements;
15import org.springframework.beans.factory.annotation.Autowired;
16import org.springframework.scheduling.annotation.Scheduled;
17import org.springframework.stereotype.Component;
18
19import static com.summo.sbmy.common.enums.HotSearchEnum.BAIDU;
20
21/**
22 * @author summo
23 * @version BaiduHotSearchJob.java, 1.0.0
24 * @description 百度热搜Java爬虫代码
25 * @date 2024年08月19
26 */
27@Component
28@Slf4j
29public class BaiduHotSearchJob {
30
31    @Autowired
32    private SbmyHotSearchService sbmyHotSearchService;
33
34    /**
35     * 定时触发爬虫方法,1个小时执行一次
36     */
37    @Scheduled(fixedRate = 1000 * 60 * 60)
38    public void hotSearch() throws IOException {
39        try {
40            //获取百度热搜
41            String url = "https://top.baidu.com/board?tab=realtime&sa=fyb_realtime_31065";
42            List<SbmyHotSearchDO> sbmyHotSearchDOList = new ArrayList<>();
43            Document doc = Jsoup.connect(url).get();
44            //标题
45            Elements titles = doc.select(".c-single-text-ellipsis");
46            //图片
47            Elements imgs = doc.select(".category-wrap_iQLoo .index_1Ew5p").next("img");
48            //内容
49            Elements contents = doc.select(".hot-desc_1m_jR.large_nSuFU");
50            //推荐图
51            Elements urls = doc.select(".category-wrap_iQLoo a.img-wrapper_29V76");
52            //热搜指数
53            Elements levels = doc.select(".hot-index_1Bl1a");
54            for (int i = 0; i < levels.size(); i++) {
55                SbmyHotSearchDO sbmyHotSearchDO = SbmyHotSearchDO.builder().hotSearchResource(BAIDU.getCode()).build();
56                //设置文章标题
57                sbmyHotSearchDO.setHotSearchTitle(titles.get(i).text().trim());
58                //设置百度三方ID
59                sbmyHotSearchDO.setHotSearchId(getHashId(BAIDU.getDesc() + sbmyHotSearchDO.getHotSearchTitle()));
60                //设置文章封面
61                sbmyHotSearchDO.setHotSearchCover(imgs.get(i).attr("src"));
62                //设置文章摘要
63                sbmyHotSearchDO.setHotSearchExcerpt(contents.get(i).text().replaceAll("查看更多>", ""));
64                //设置文章连接
65                sbmyHotSearchDO.setHotSearchUrl(urls.get(i).attr("href"));
66                //设置热搜热度
67                sbmyHotSearchDO.setHotSearchHeat(levels.get(i).text().trim());
68                //按顺序排名
69                sbmyHotSearchDO.setHotSearchOrder(i + 1);
70                sbmyHotSearchDOList.add(sbmyHotSearchDO);
71            }
72            //数据持久化
73            sbmyHotSearchService.saveCache2DB(sbmyHotSearchDOList);
74        } catch (IOException e) {
75            log.error("获取百度数据异常", e);
76        }
77    }
78
79    /**
80     * 根据文章标题获取一个唯一ID
81     *
82     * @param title 文章标题
83     * @return 唯一ID
84     */
85    public static String getHashId(String title) {
86        long seed = title.hashCode();
87        Random rnd = new Random(seed);
88        return new UUID(rnd.nextLong(), rnd.nextLong()).toString();
89    }
90
91}
92
其实网页版的数据爬虫也不难,关键就看你能不能快速找到存数据的标签,然后通过选择器获取到标签的属性或内容,Jsoup框架在解析dom是很好用的,也常用在爬虫代码中。