sync.WaitGroup 是 Golang 中常用的并发措施,我们可以用它来等待一批 Goroutine 结束。
WaitGroup 的源码也非常简短,抛去注释外也就 100 行左右的代码。但即使是这 100 行代码,里面也有着关乎内存优化、并发安全考虑等各种性能优化手段。
本文将基于 go-1.13 的源码 进行分析,将会涉及以下知识点:
-
WaitGroup 的实现逻辑
-
WaitGroup 的底层内存结构及性能优化
-
WaitGroup 的内部如何实现无锁操作
WaitGroup 的使用
在正式分析源码之前,我们先看下 WaitGroup 的基本用法:
1func main() {
2 var wg sync.WaitGroup
3 for i := 1; i <= 5; i++ {
4  wg.Add(1)
5  go func() {
6   defer wg.Done()
7   println("hello")
8  }()
9 }
10
11 wg.Wait()
12}
从上述代码可以看出,WaitGroup 的用法非常简单:使用 Add 添加需要等待的个数,使用 Done 来通知 WaitGroup 任务已完成,使用 Wait 来等待所有 goroutine 结束。
WaitGroup 的实现逻辑
我们首先看下 WaitGroup 的组成结构,代码如下:
1type WaitGroup struct {
2 noCopy noCopy
3 state1 [3]uint32
4}
其中 noCopy 是 golang 源码中检测禁止拷贝的技术。如果程序中有 WaitGroup 的赋值行为,使用 go vet 检查程序时,就会发现有报错。但需要注意的是,noCopy 不会影响程序正常的编译和运行。
state1 [3]uint32 字段中包含了 WaitGroup 的所有状态数据。该字段的整个设计其实非常复杂,为了便于快速理解 WaitGroup 的主流程,我们将在后面部分单独剖析 state1。
为了便于理解 WaitGroup 的整个实现过程,我们暂时先不考虑内存对齐和并发安全等方面因素。那么 WaitGroup 可以近似的看做以下代码:
1type WaitGroup struct {
2 counter int32
3 waiter  uint32
4 sema    uint32
5}
其中:
-
counter代表目前尚未完成的个数。WaitGroup.Add(n)将会导致counter += n, 而WaitGroup.Done()将导致counter--。 -
waiter代表目前已调用WaitGroup.Wait的 goroutine 的个数。 -
sema对应于 golang 中 runtime 内部的信号量的实现。WaitGroup 中会用到 sema 的两个相关函数,runtime_Semacquire和runtime_Semrelease。runtime_Semacquire表示增加一个信号量,并挂起 当前 goroutine。runtime_Semrelease表示减少一个信号量,并唤醒 sema 上其中一个正在等待的 goroutine。
WaitGroup 的整个调用过程可以简单地描述成下面这样:
-
当调用
WaitGroup.Add(n)时,counter 将会自增:counter += n -
当调用
WaitGroup.Wait()时,会将waiter++。同时调用runtime_Semacquire(semap), 增加信号量,并挂起当前 goroutine。 -
当调用
WaitGroup.Done()时,将会counter--。如果自减后的 counter 等于 0,说明 WaitGroup 的等待过程已经结束,则需要调用 runtime_Semrelease 释放信号量,唤醒正在WaitGroup.Wait的 goroutine。
以上就是 WaitGroup 实现过程的简略版。但实际上,WaitGroup 在实现过程中对并发性能以及内存占用优化上,都有一些非常巧妙的设计点,我们接下来要着重讨论下。
WaitGroup 的底层内存结构
我们回来讨论 WaitGroup 中 state1 的内存结构。state1 长度为 3 的 uint32 数组,但正如我们上文讨论,其中 state1 中包含了三个变量的语义和行为,其内存结构如下:
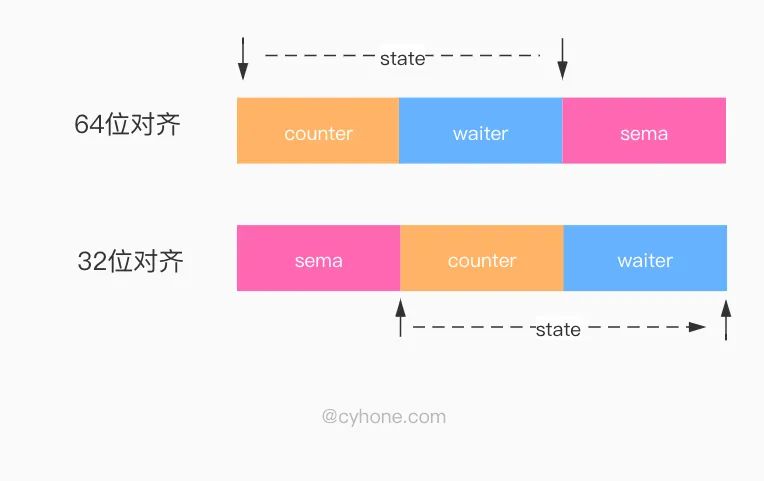
WaitGroup 内存布局
我们在图中提到了 Golang 内存对齐的概念。简单来说,如果变量是 64 位对齐 (8 byte), 则该变量的起始地址是 8 的倍数。如果变量是 32 位对齐 (4 byte),则该变量的起始地址是 4 的倍数。
从图中看出,当 state1 是 32 位对齐和 64 位对齐的情况下,state1 中每个元素的顺序和含义也不一样:
-
当
state1是 32 位对齐:state1数组的第一位是 sema,第二位是 counter,第三位是 waiter。 -
当
state1是 64 位对齐:state1数组的第一位是 counter,第二位是 waiter,第三位是 sema。
为什么会有这种奇怪的设定呢?这里涉及两个前提:
前提 1:在 WaitGroup 的真实逻辑中, counter 和 waiter 被合在了一起,当成一个 64 位的整数对外使用。当需要变化 counter 和 waiter 的值的时候,也是通过 atomic 来原子操作这个 64 位整数。但至于为什么合在一起,我们会在下文详细讨论。
前提 2:在 32 位系统下,如果使用 atomic 对 64 位变量进行原子操作,调用者需要自行保证变量的 64 位对齐,否则将会出现异常。golang 的官方文档 sync/atomic/#pkg-note-BUG 原文是这么说的:
On ARM, x86-32, and 32-bit MIPS, it is the caller’s responsibility to arrange for 64-bit alignment of 64-bit words accessed atomically. The first word in a variable or in an allocated struct, array, or slice can be relied upon to be 64-bit aligned.
因此,在前提 1 的情况下,WaitGroup 需要对 64 位进行原子操作。根据前提 2,WaitGroup 需要自行保证 count+waiter 的 64 位对齐。这也是 WaitGroup 采用 [3]uint32 存储变量的目的:
-
当
state1变量是 64 位对齐时,也就意味着数组前两位作为 64 位整数时,自然也可以保证 64 位对齐了。 -
当
state1变量是 32 位对齐时,我们把数组第 1 位作为对齐的 padding,因为state1本身是 uint32 的数组,所以数组第一位也有 32 位。这样就保证了把数组后两位看做统一的 64 位整数时是64位对齐的。
这个方法非常的巧妙,只不过是改变 sema 的位置顺序,就既可以保证 counter+waiter 一定会 64 位对齐,也可以保证内存的高效利用。
Golang 官方文档中也给出了 判断当前变量是 32 位对齐还是 64 位对齐的方法::
1uintptr(unsafe.Pointer(&x)) % unsafe.Alignof(x) == 0
WaitGroup 中从 state1 中取变量的方法如下:
1func (wg *WaitGroup) state() (statep *uint64, semap *uint32) {
2 if uintptr(unsafe.Pointer(&wg.state1))%8 == 0 {
3  return (*uint64)(unsafe.Pointer(&wg.state1)), &wg.state1[2]
4 } else {
5  return (*uint64)(unsafe.Pointer(&wg.state1[1])), &wg.state1[0]
6 }
7}
注: 有些文章会讲到,WaitGroup 两种不同的内存布局方式是 32 位系统和 64 位系统的区别,这其实不太严谨。准确的说法是 32 位对齐和 64 位对齐的区别。因为在 32 位系统下,state1 变量也有可能恰好符合 64 位对齐。
WaitGroup 的无锁实现
我们上文讲到,在 WaitGroup 中,其实是把 counter 和 waiter 看成一个 64 位整数进行处理,但为什么要这么做呢?分成两个 32 位变量岂不是更方便?这其实是 WaitGroup 的一个性能优化手段。
counter 和 waiter 在改变时需要保证并发安全。对于这种场景,我们最简单的做法是,搞一个 Mutex 或者 RWMutex 锁, 在需要读写 counter 和 waiter 的时候,加锁就完事。但是我们知道加锁必然会造成额外的性能开销,作为 Golang 系统库,自然需要把性能压榨到极致。
WaitGroup 直接把 counter 和 waiter 看成了一个统一的 64 位变量。其中 counter 是这个变量的高 32 位,waiter 是这个变量的低 32 位。在需要改变 counter 时, 通过将累加值左移 32 位的方式:atomic.AddUint64(statep, uint64(delta)<<32),即可实现 count += delta 同样的效果。
在 Wait 函数中,通过 CAS 操作 atomic.CompareAndSwapUint64(statep, state, state+1), 来对 waiter 进行自增操作,如果 CAS 操作返回 false,说明 state 变量有修改,有可能是 counter 发生了变化,这个时候需要重试检查逻辑条件。
还有一个小细节值得一提的是,因为 WaitGroup 是可以复用的,因此在 Wait 结束的时候需要将 waiter--,重置状态。但这肯定会涉及到一次原子变量操作。如果调用 Wait 的 goroutine 比较多,那这个原子操作也会随之进行很多次。但 WaitGroup 这里直接在Done 的时候,当 counter 等于 0 时,直接将 counter+waiter 整个 64 位整数全部置 0,既可以达到重置状态的效果,也免于进行多次原子操作。
总结
Waitgroup 虽然只有 100 行左右的代码。作为语言的内置库,我们从中可以看出作者对每个细节的极致打磨,非常精细的针对场景优化性能,这也给我们写程序带来了很多启发。
参考
-
Go:Size_and_alignment_guarantees
-
Dig101-Go 之聊聊 struct 的内存对齐
本文转自 https://mp.weixin.qq.com/s/CkSd2aldYaoLbd-IKhkpWg,如有侵权,请联系删除。