文章目录
背景
在做后台接口开发时,我们总会遇到新增字段或者修改字段的问题。
在开发阶段我们可以删表重建,但是上线之后可不能这么搞了。所以数据迁移就很重要了。
所谓的数据迁移原理其实就是将数据复制出来然后再把表删了重新建表同时把数据再复制进去。
这里我用到的ORM是Sequelize所以下面简单介绍一下Sequelize实现数据迁移的过程。
实现
安装 sequelize/cli 依赖
npm install --save-dev sequelize-cli
初始化

在项目目录(我这里是starter)执行下面的命令
npx sequelize-cli init
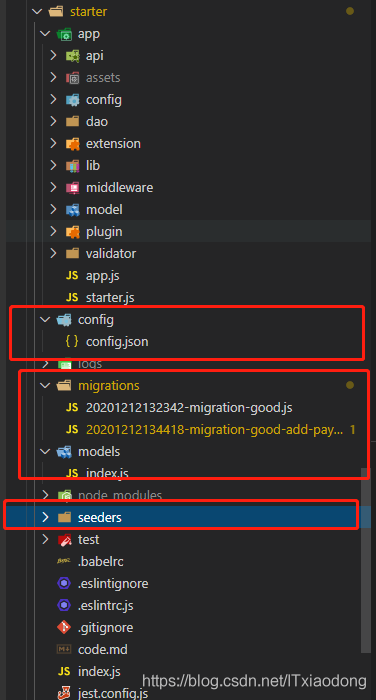
会在当前目录下生成相关目录如下:
-
config/config.json:包含配置文件,它告诉CLI如何连接数据库。可直接从项目的数据库配置中复制过来,内容如下:{
"development": {
1"username": "root",
2"password": "数据库密码",
3"database": "lin-cms",
4"host": "localhost",
5"dialect": "mysql"
}, "test": {
1"username": "root",
2"password": "数据库密码",
3"database": "lin-cms",
4"host": "localhost",
5"dialect": "mysql"
}, "production": {
1"username": "root",
2"password": "数据库密码",
3"database": "lin-cms",
4"host": "localhost",
5"dialect": "mysql"
} }
-
migrations:包含所有迁移文件。数据迁移的主要文件,后面介绍。 -
seeders:包含所有种子文件。使用样本数据或测试数据填充数据库表时可以使用seeders文件去实现。比如向用户表中插入用户:module.exports = {
up: (queryInterface, Sequelize) => {
1return queryInterface.bulkInsert('Users', [{
2
3
4
5  firstName: 'John',
6  lastName: 'Doe',
7  email: 'example@example.com',
8  createdAt: new Date(),
9  updatedAt: new Date()
10}]);
}, down: (queryInterface, Sequelize) => {
return queryInterface.bulkDelete('Users', null, {}); } };
-
models:包含你的项目的所有模型。
实现数据迁移
目的是要在已经存在的
goods表中增加pay_type字段,并且不删除表中的数据。
我们先按照上面的步骤完成初始化之后,就可以创建迁移文件了。
可通过如下命令创建文件:
npx sequelize-cli migration:generate --name migration-good-add-paytype-column
migration-good-add-paytype-column:是我们的迁移文件名称
执行完之后会在migrations文件夹下生成文件:

接下来就是在该文件中编写迁移逻辑了,文件内容如下:
1'use strict';
2
3module.exports = {
4
5
6
7  up: async (queryInterface, Sequelize) => {
8
9
10
11    /**
12     * Add altering commands here. 更新的操作
13     *
14     * Example:
15     * await queryInterface.createTable('users', { id: Sequelize.INTEGER });
16     */
17    return queryInterface.sequelize.transaction(t => {
18
19
20
21      return Promise.all([
22      // 在 goods 表中增加 string 类型的 pay_type 字段
23        queryInterface.addColumn('Goods', 'pay_type', {
24
25
26
27          type: Sequelize.DataTypes.STRING
28        }, {
29
30
31    transaction: t }),
32
33      ]);
34    });
35  },
36
37  down: async (queryInterface, Sequelize) => {
38
39
40
41    /**
42     * Add reverting commands here. 回退的操作
43     *
44     * Example:
45     * await queryInterface.dropTable('users');
46     */
47  }
48};
49
编写完迁移逻辑之后,执行如下命令即可完成数据迁移:
npx sequelize-cli db:migrate
最后我们可以在数据库表中看到已经在现有数据的基础上增加了pay_type字段。

多表依赖可参考文档中的介绍。
Sequelize 高级专题
TIP:
在新增完字段之后,应该还需要在原有的Model对象里面添加,如这里是model/good.js需要增加pay_type否则添加商品信息该字段没有添加成功。(目前测试是这样)
1import sequelize from '../lib/db';
2import {
3
4
5
6    Sequelize
7} from 'sequelize';
8import {
9
10
11
12    GoodParentCategory
13} from './good-category';
14
15// 这是我们用于以下示例的模型的设置
16const Good = sequelize.define('good', {
17
18
19
20    id: {
21
22
23
24        type: Sequelize.INTEGER,
25        primaryKey: true,
26        autoIncrement: true
27    },
28    title: {
29
30
31
32        type: Sequelize.STRING(50),
33        allowNull: false
34    },
35     // 新增
36    brand:{
37
38
39
40        type: Sequelize.STRING(50),
41        allowNull: false
42    },
43    image: {
44
45
46
47        type: Sequelize.STRING(100),
48        allowNull: false
49    },
50    category: {
51
52
53
54        type: Sequelize.STRING(10),
55        allowNull: false
56    },
57    stock: {
58
59
60
61        type: Sequelize.INTEGER,
62        allowNull: false
63    },
64    original_price: {
65
66
67
68        type: Sequelize.INTEGER,
69        allowNull: false
70    },
71    price: {
72
73
74
75        type: Sequelize.INTEGER,
76        allowNull: false
77    },
78    // 新增
79    pay_type:{
80
81
82
83        type: Sequelize.STRING(10),
84        allowNull: false
85    },
86    summary: {
87
88
89
90        type: Sequelize.STRING(1000),
91        allowNull: false
92    },
93});
94GoodParentCategory.hasMany(Good);
95Good.belongsTo(GoodParentCategory);
96
97export {
98
99
100
101    Good
102};
参考
本文同步分享在 博客“_龙衣”(CSDN)。
如有侵权,请联系 support@oschina.cn 删除。
本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。