大家好,在之前我们讲过如何用Python构建一个带有GUI的爬虫小程序,很多本文将迎合热点,延续上次的NBA爬虫GUI,探讨如何爬取虎扑NBA官网数据。 并且将数据写入Excel中同时自动生成折线图,主要有以下几个步骤。
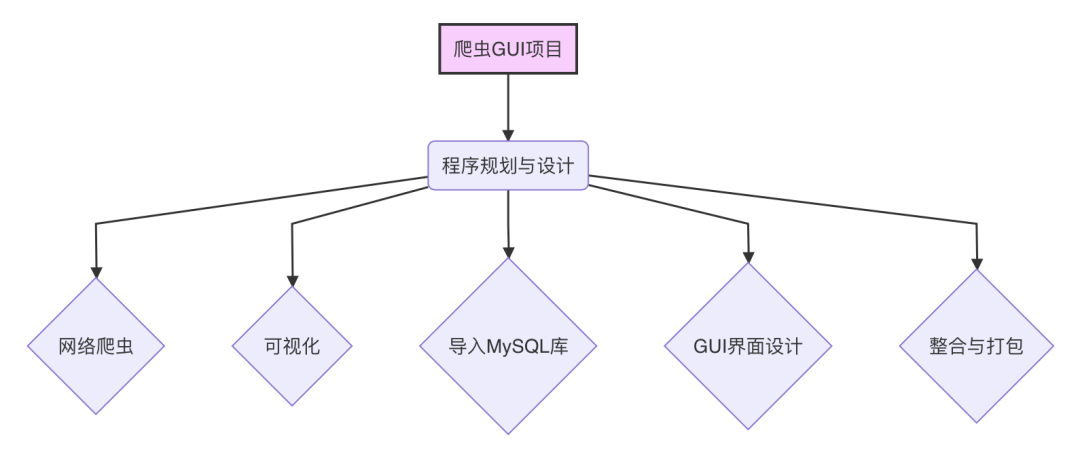
本文将分为以下两个部分进行讲解
-
在虎扑NBA官网球员页面中进行爬虫,获取球员数据。
-
清洗整理爬取的球员数据,对其进行可视化。
项目主要涉及的Python模块:
-
requests -
pandas -
bs4
爬虫部分
爬虫部分整理思路如下👇
观察URL1的源代码找到球队名称与对应URL2观察URL2的源代码找到球员对应的URL3观察URL3源代码找到对应球员基本信息与比赛数据并进行筛选存储。
其实爬虫就是在html上操作,而html的结构很简单就只有一个,就是一个大框讨一个小框,小框在套小框,这样的一层层嵌套。
目标URL如下:
-
URL1:
http://nba.hupu.com/players/ -
URL2(此处以湖人球队为例):
https://nba.hupu.com/players/lakers -
URL3(此处以詹姆斯为例):
https://nba.hupu.com/players/lebronjames-650.html
先引用模块
1from bs4 import BeautifulSoup
2import requests
3import xlsxwriter
4import os
5
查看URL1源代码代码,可以看到球队名词及其对应的URL2在span标签中<span class><a href = “...">下,进而找到它的父框与祖父框,下面的思路都是如此,图如下: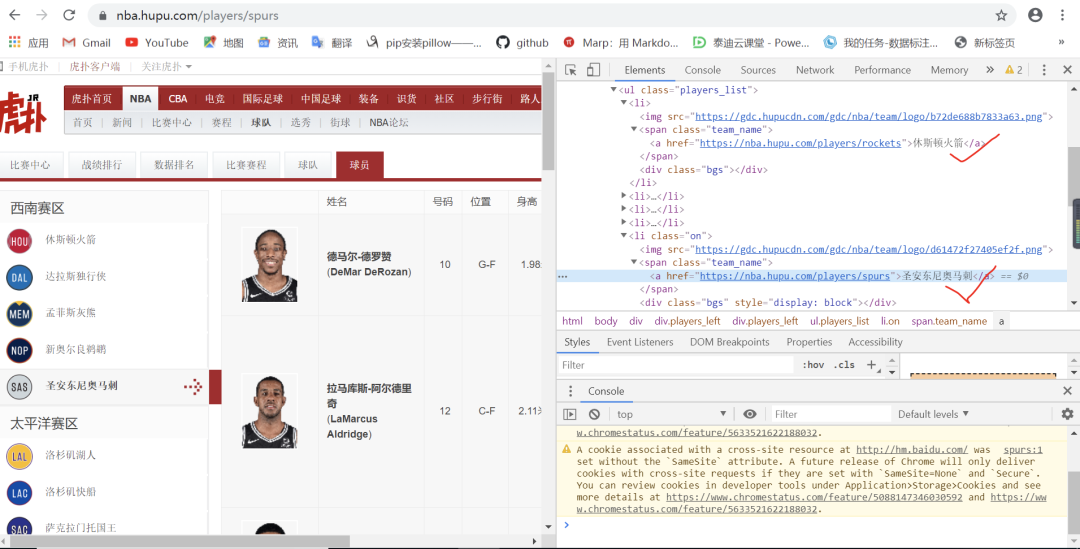
此时,可以通过requests模块与bs4模块进行有目的性的索引,得到球队的名称列表。
1def Teamlists(url):
2    TeamName=[]
3    TeamURL=[]
4    GET=requests.get(URL1)
5    soup=BeautifulSoup(GET.content,'lxml')
6    lables=soup.select('html body div div div ul li span a')
7    for lable in lables:
8        ballname=lable.get_text()
9        TeamName.append(ballname)
10        print(ballname)
11    teamname=input("请输入想查询的球队名:")#此处可变为GUI界面中的按键值
12    c=TeamName.index(teamname)
13    for item in lables:
14     HREF=item.get('href')
15     TeamURL.append(HREF)
16    URL2=TeamURL[c]
17    return URL2
就此得到了对应球队的URL2,接着观察URL2网页的内容,可以看到球员名称在标签a中<a target = "_blank" href = ....>下,同时也存放着对应球员的URL3,如下图: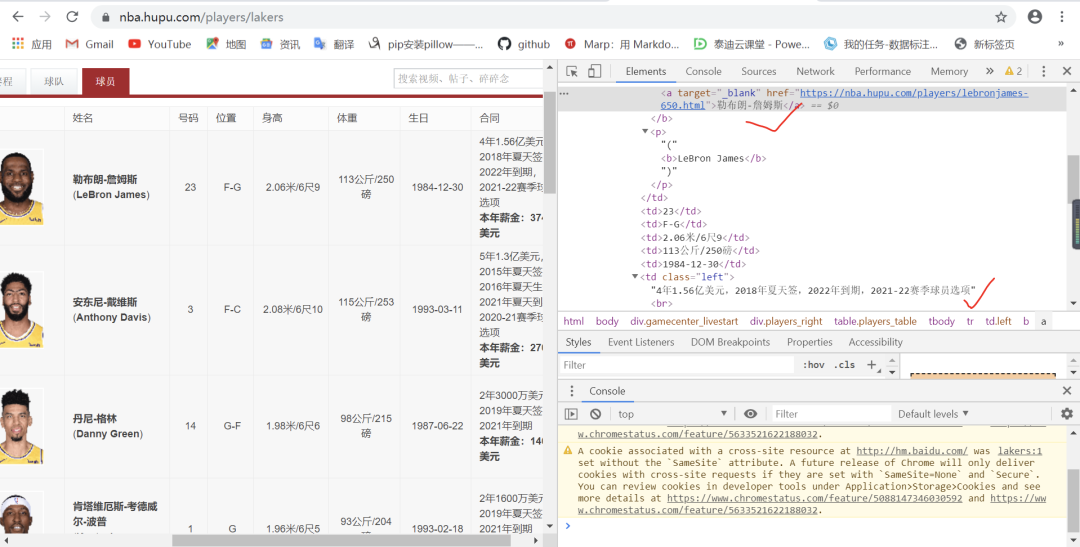
此时,故依然通过requests模块与bs4模块进行相对应的索引,得到球员名称列表以及对应的URL3。
1#自定义函数获取队员列表和对应的URL
2def playerlists(URL2):
3    PlayerName=[]
4    PlayerURL=[]
5    GET2=requests.get(URL1)
6    soup2=BeautifulSoup(GET2.content,'lxml')
7    lables2=soup2.select('html body div div table tbody tr td b a')
8    for lable2 in lables2:
9        playername=lable2.get_text()
10        PlayerName.append(playername)
11        print(playername)
12    name=input("请输入球员名:") #此处可变为GUI界面中的按键值
13    d=PlayerName.index(name)
14    for item2 in lables2:
15     HREF2=item2.get('href')
16     PlayerURL.append(HREF2)
17    URL3=PlayerURL[d]
18    return URL3,name
19
现在就此得到了对应球队的URL3,接着观察URL3网页的内容,可以看到球员基本信息在标签p下,球员常规赛生涯数据与季后赛生涯数据在标签td下,如下图: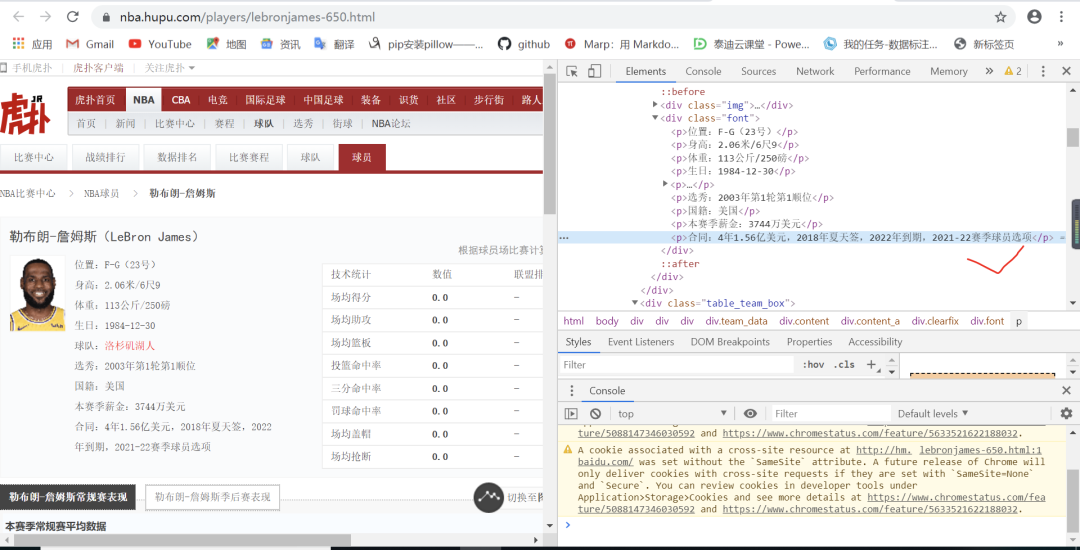
同样,依然通过requests模块与bs4模块进行相对应的索引,得到球员基本信息与生涯数据,而对于球员的常规赛与季候赛的生涯数据将进行筛选与储存,得到data列表。
1def Competition(URL3):
2    data=[]
3    GET3=requests.get(URL3)
4    soup3=BeautifulSoup(GET3.content,'lxml')
5    lables3=soup3.select('html body div div div div div div div div p')
6    lables4=soup3.select('div div table tbody tr td')
7    for lable3 in lables3:
8     introduction=lable3.get_text()
9     print(introduction)  #球员基本信息
10    for lable4 in lables4:
11        competition=lable4.get_text()
12        data.append(competition)
13    for i in range(len(data)):
14        if data[i]=='职业生涯常规赛平均数据':
15            a=data[i+31]
16            a=data.index(a)
17    del(data[:a])
18    for x in range(len(data)):
19        if data[x]=='职业生涯季后赛平均数据':
20            b=data[x]
21            b=data.index(b)
22    del(data[b:])
23    return data
24
通过上述网络爬虫得到了以下的数据,提供可视化数据的同时便于绑定之后的GUI界面按键事件:
-
获取NBA中的所有球队的标准名称;
-
通过指定的一只球队获取球队中所有球员的标准名称;
-
通过指定的球员获取到对应的基本信息以及常规赛与季后赛数据;
可视化部分
思路:创建文件夹 创建表格和折线图
自定义函数创建表格,运用os模块进行编写,返回已创文件夹的路径,代码如下:
1def file_add(path):  #此时的内函数path可与GUI界面的Statictext绑定
2    creatpath=path+'\\Basketball'
3    try:
4     if not os.path.isdir(creatpath):
5      os.makedirs(creatpath)
6    except:
7     print("文件夹存在")
8    return creatpath
9
运用xlsxwriter模块在creatpath路径下自定义函数创建excel表格同时放入数据与构造折线图,代码如下:
1def player_chart(name,data,creatpath):
2    #此为表格名称——球员名称+chart
3    EXCEL=xlsxwriter.Workbook(creatpath+'\\'+name+'chart.xlsx')
4    worksheet=EXCEL.add_worksheet(name)
5    bold=EXCEL.add_format({'bold':1})
6    headings=data[:18]
7    worksheet.write_row('A1',headings,bold) #写入表头
8    num=(len(data))//18
9    a=0
10    for i in range(num):
11        a=a+18
12        c=a+18
13        i=i+1
14        worksheet.write_row('A'+str(i+1),data[a:c]) #写入数据
15    chart_col = EXCEL.add_chart({'type': 'line'}) #创建一个折线图
16    chart_col.add_series({
17        'name': '='+name+'!$R$1', #设置折线描述名称
18        'categories':'='+name+'!$A$2:$A$'+str(num), #设置图表类别标签范围
19        'values': '='+name+'!$R$2:$R$'+str(num-1),    #设置图表数据范围
20        'line': {'color': 'red'}, })   #设置图表线条属性
21    #设置图标的标题和想x,y轴信息
22    chart_col.set_title({'name': name+'生涯常规赛平均得分'})
23    chart_col.set_x_axis({'name': '年份 (年)'})
24    chart_col.set_y_axis({'name': '平均得分(分)'})
25    chart_col.set_style(1) #设置图表风格
26    worksheet.insert_chart('A14', chart_col, {'x_offset':25, 'y_offset':3,}) #把图标插入工作台中并设置偏移
27    EXCEL.close()
28
数据表格效果展现,以詹姆斯为例如下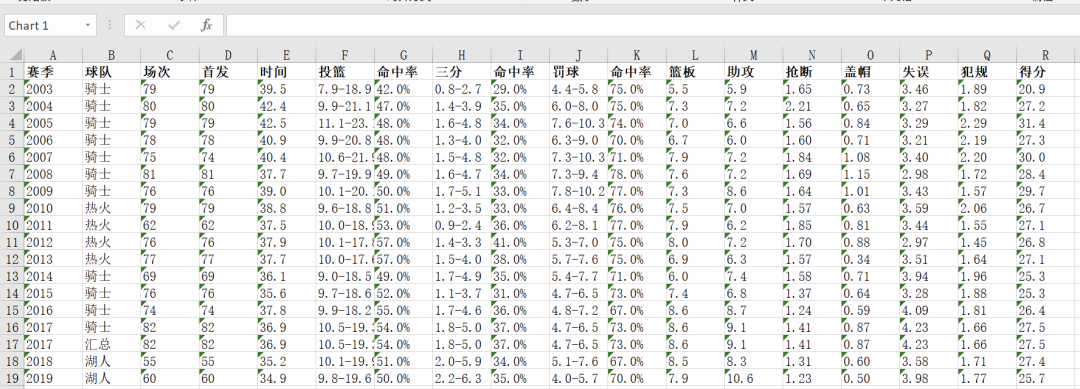
并且此时打开自动生成的Excel,对应的折线图就直接展现出来,无需再次整理!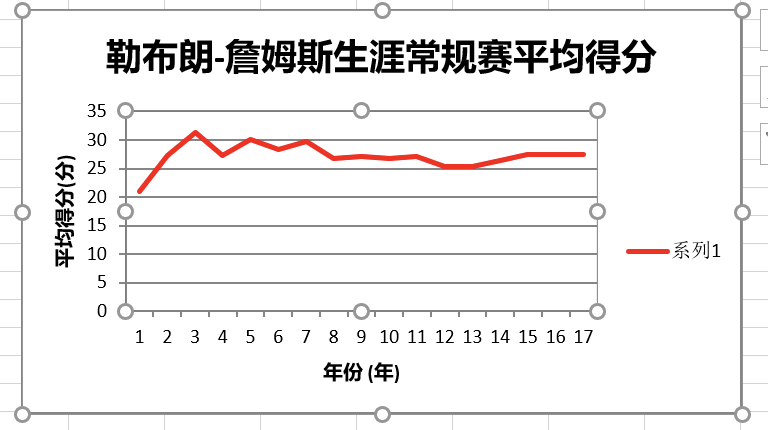
现在结合任务一的网络爬虫与任务二的数据可视化,可以得到实时的球员常规赛数据与季后赛数据汇总,同时还有实时球员生涯折线图。便可以与上次的GUI界面任务设计中的”可视化“按钮事件绑定,感兴趣的读者可以自己进一步研究!
-------------------********************************** End **********-------------**-----********-**********************************
往期精彩文章推荐:
欢迎各位大佬点击链接加入群聊【helloworld开发者社区】:https://jq.qq.com/?_wv=1027&k=mBlk6nzX进群交流IT技术热点。
本文转自 https://mp.weixin.qq.com/s/RbNfb0WCuadqsl4wFXedzg,如有侵权,请联系删除。